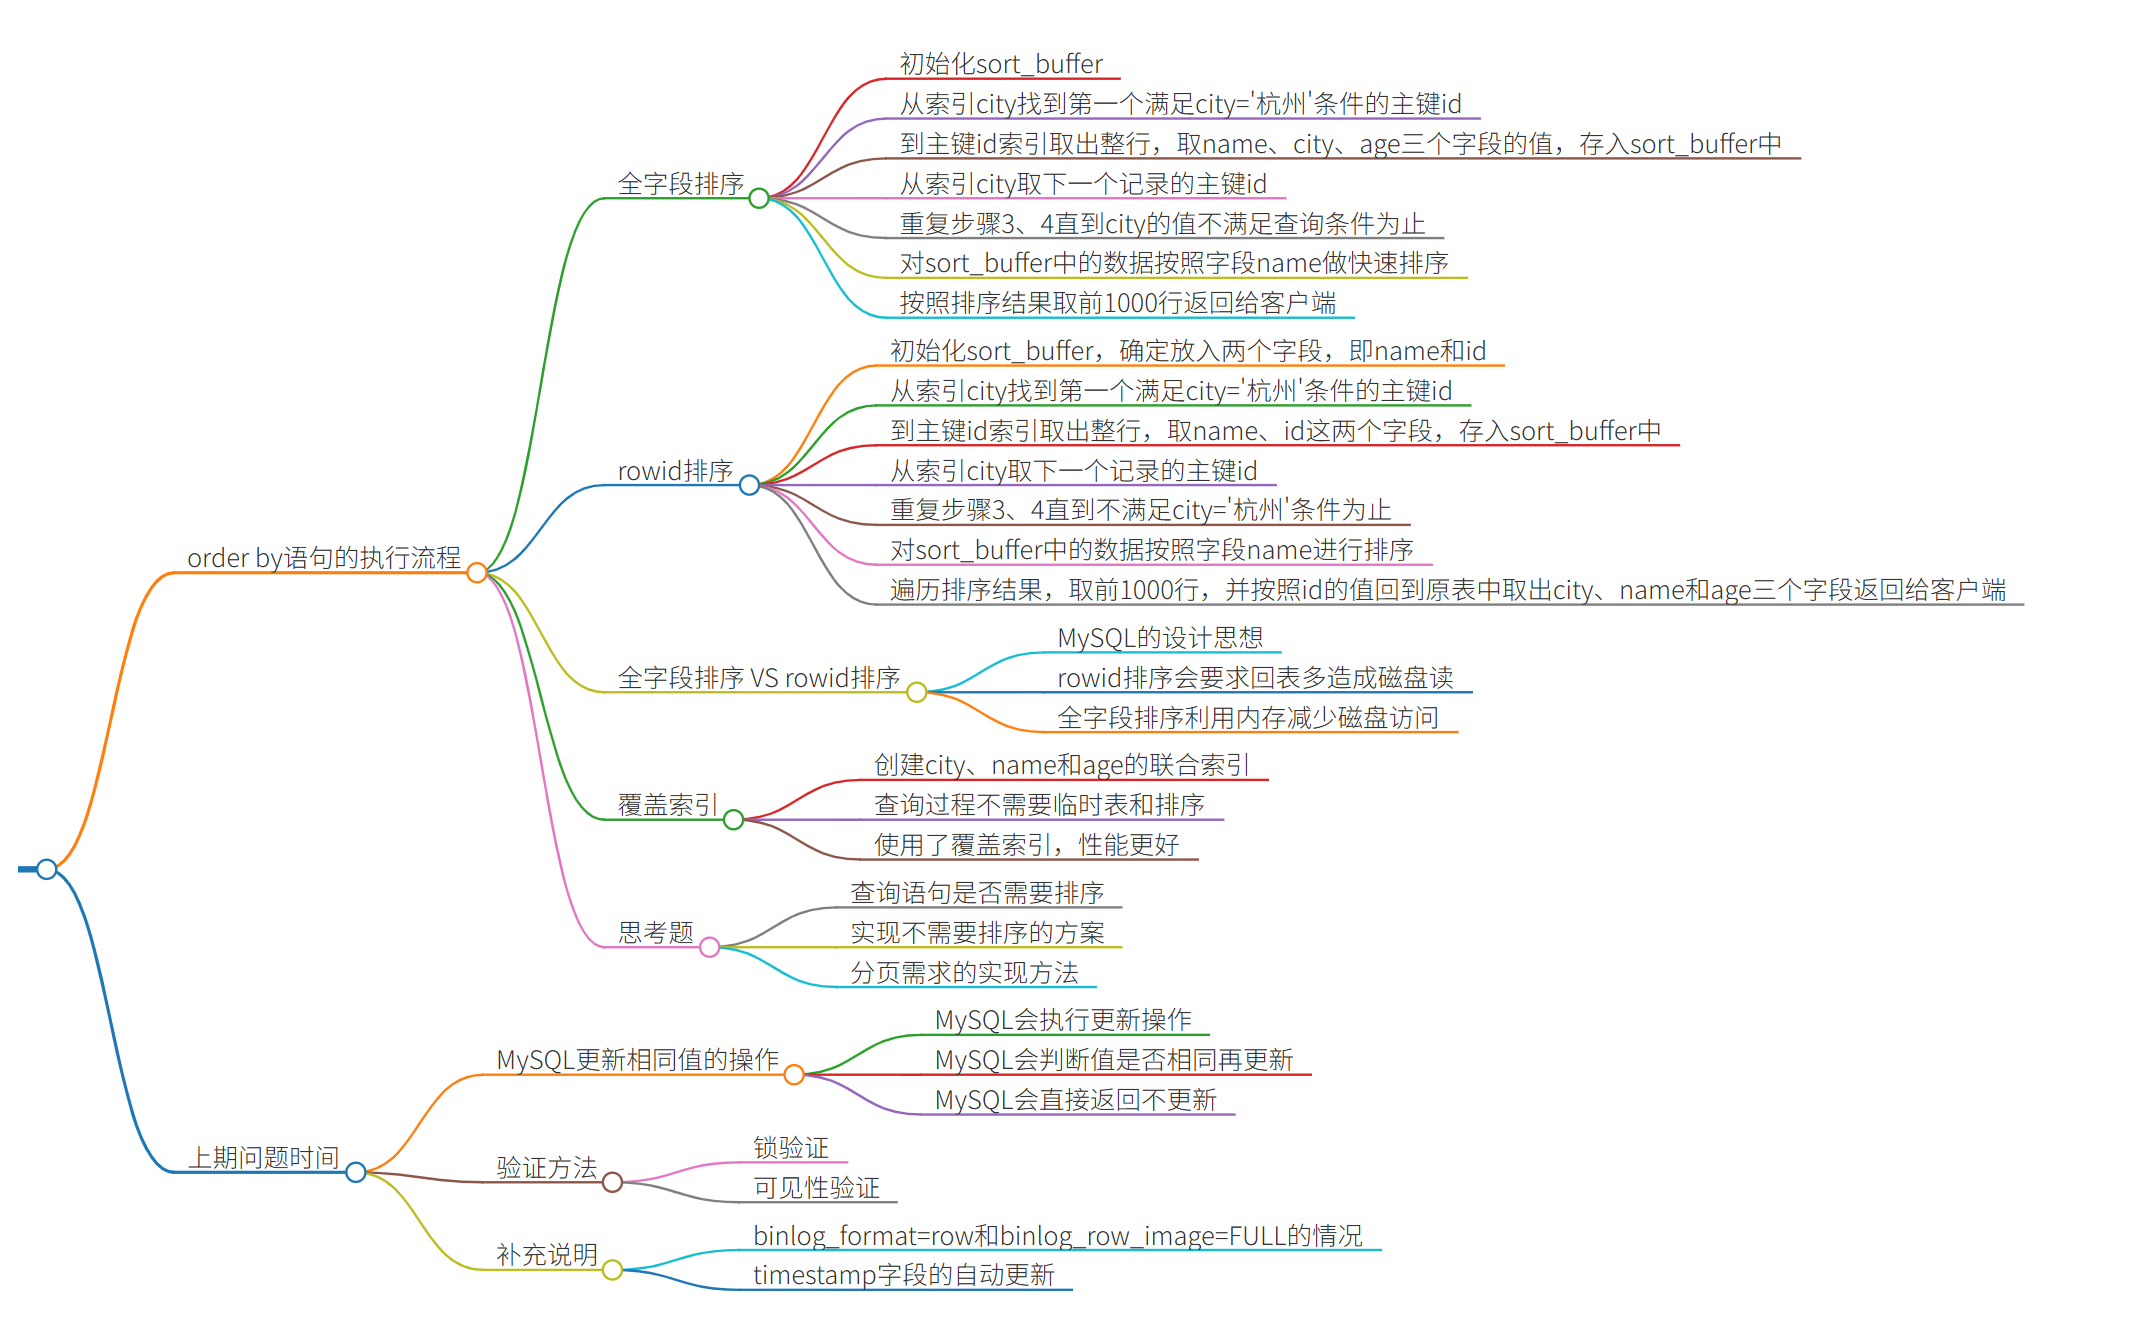
16 | “order by”是怎么工作的?
在你开发应用的时候,一定会经常碰到需要根据指定的字段排序来显示结果的需求。还是以我们前面举例用过的市民表为例,假设你要查询城市是“杭州”的所有人名字,并且按照姓名排序返回前 1000 个人的姓名、年龄。
假设这个表的部分定义是这样的:
CREATE TABLE `t` (
    `id` int(11) NOT NULL,
    `city` int(11) NOT NULL,
    `name` varchar(16) NOT NULL,
    `age` int(11) NOT NULL,
    `addr` varchar(128) DEFAULT NULL,
    PRIMARY KEY (`id`),
    KEY `city` (`city`)
) ENGINE=InnoDB;
这时,你的 SQL 语句可以这么写;
select city,name,age from t where city='杭州' order by name limit 1000 ;这个语句看上去逻辑很清晰,但是你了解它的执行流程吗?今天,我就和你聊聊这个语句是怎么执行的,以及有什么参数会影响执行的行为。
全字段排序
前面我们介绍过索引,所以你现在就很清楚了,为避免全表扫描,我们需要在 city 字段加上索引。
在 city 字段上创建索引之后,我们用 explain 命令来看看这个语句的执行情况。

Extra 这个字段中的“Using filesort”表示的就是需要排序,MySQL 会给每个线程分配一块内存用于排序,称为 sort_buffer。
为了说明这个 SQL 查询语句的执行过程,我们先来看一下 city 这个索引的示意图。
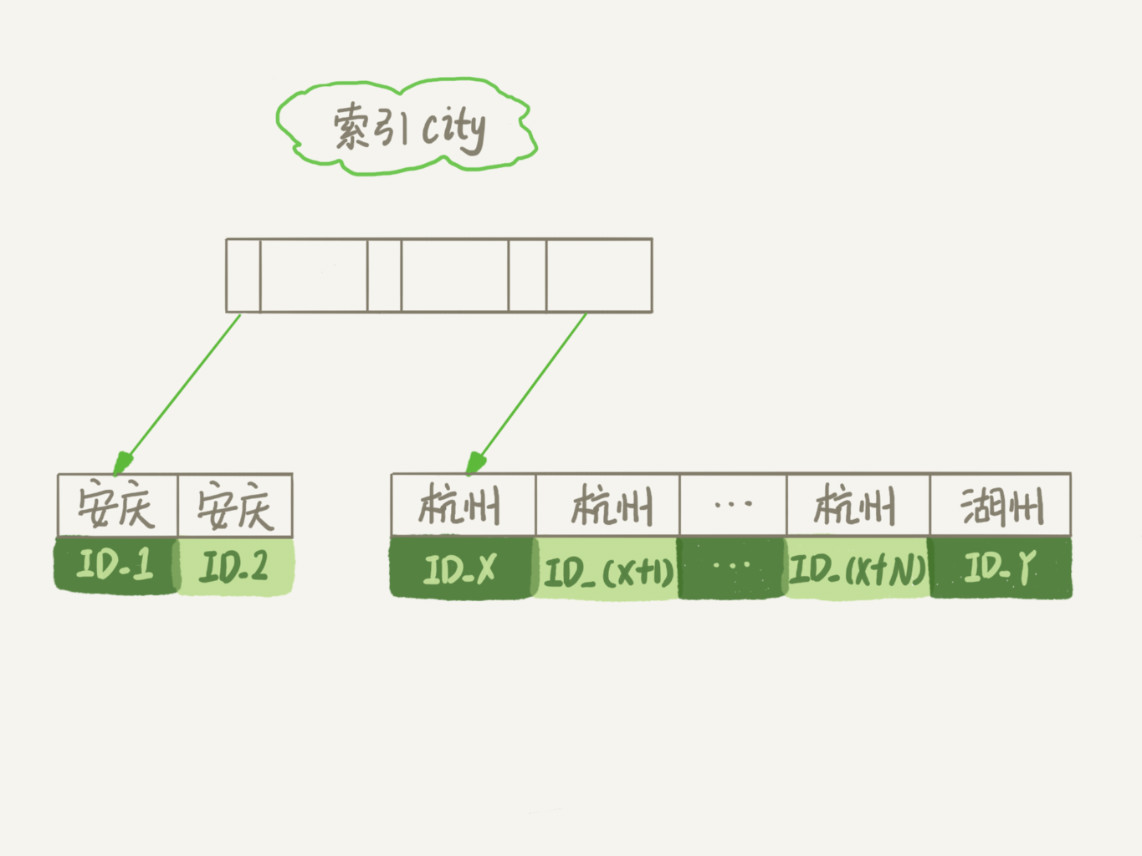
从图中可以看到,满足 city='杭州’条件的行,是从 ID_X 到 ID_(X+N) 的这些记录。
通常情况下,这个语句执行流程如下所示 :
- 初始化 sort_buffer,确定放入 name、city、age 这三个字段;
- 从索引 city 找到第一个满足 city='杭州’条件的主键 id,也就是图中的 ID_X;
- 到主键 id 索引取出整行,取 name、city、age 三个字段的值,存入 sort_buffer 中;
- 从索引 city 取下一个记录的主键 id;
- 重复步骤 3、4 直到 city 的值不满足查询条件为止,对应的主键 id 也就是图中的 ID_Y;
- 对 sort_buffer 中的数据按照字段 name 做快速排序;
- 按照排序结果取前 1000 行返回给客户端。
我们暂且把这个排序过程,称为全字段排序,执行流程的示意图如下所示,下一篇文章中我们还会用到这个排序。
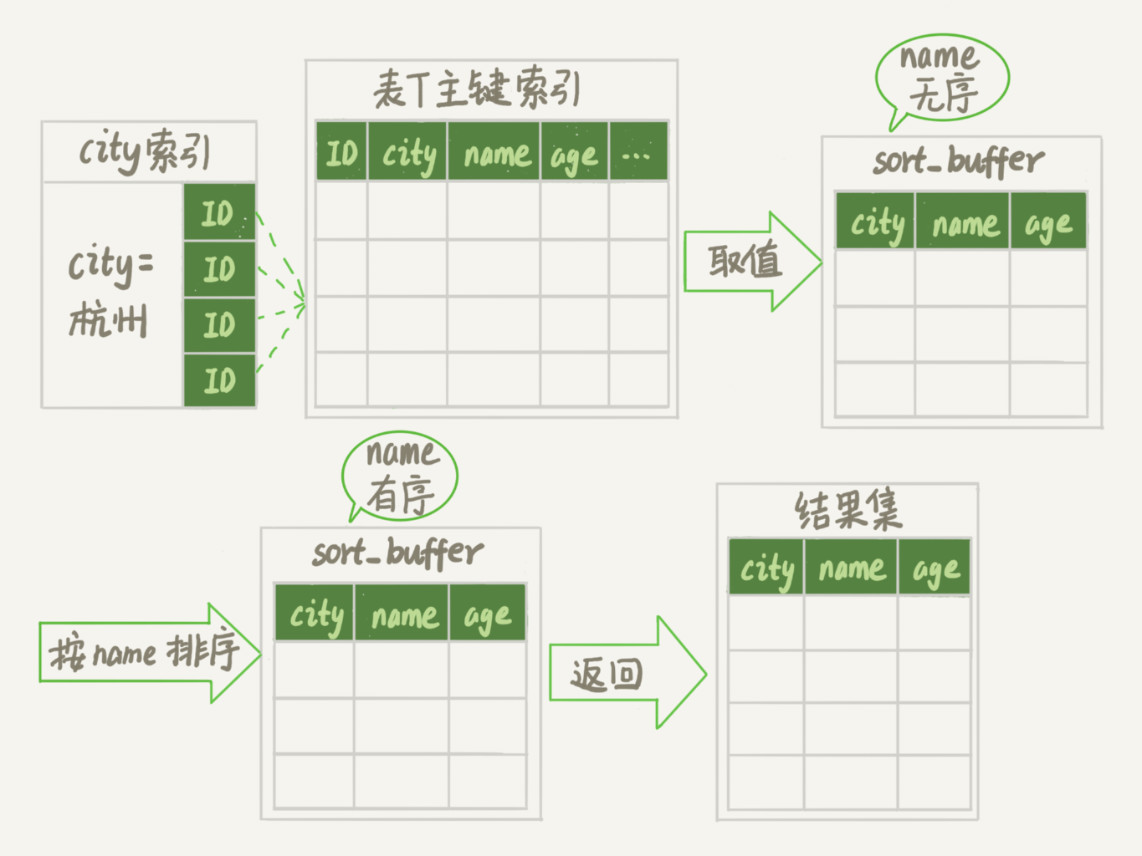
图中“按 name 排序”这个动作,可能在内存中完成,也可能需要使用外部排序,这取决于排序所需的内存和参数 sort_buffer_size。
sort_buffer_size,就是 MySQL 为排序开辟的内存(sort_buffer)的大小。如果要排序的数据量小于 sort_buffer_size,排序就在内存中完成。但如果排序数据量太大,内存放不下,则不得不利用磁盘临时文件辅助排序。
你可以用下面介绍的方法,来确定一个排序语句是否使用了临时文件。
/* 打开 optimizer_trace,只对本线程有效 */
SET optimizer_trace='enabled=on';

/* @a 保存 Innodb_rows_read 的初始值 */
select VARIABLE_VALUE into @a from performance_schema.session_status where variable_name = 'Inn

/* 执行语句 */
select city, name,age from t where city='杭州' order by name limit 1000;

/* 查看 OPTIMIZER_TRACE 输出 */
SELECT * FROM `information_schema`.`OPTIMIZER_TRACE`\G

/* @b 保存 Innodb_rows_read 的当前值 */
select VARIABLE_VALUE into @b from performance_schema.session_status where variable_name = 'Inno

/* 计算 Innodb_rows_read 差值 */
select @b-@a;
这个方法是通过查看 OPTIMIZER_TRACE 的结果来确认的,你可以从 number_of_tmp_files 中看到是否使用了临时文件。
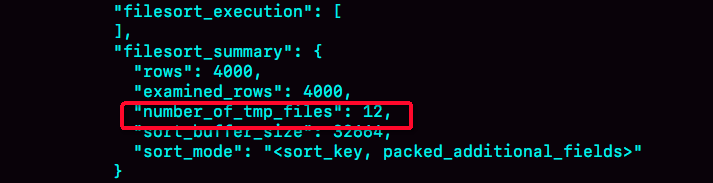
number_of_tmp_files 表示的是,排序过程中使用的临时文件数。你一定奇怪,为什么需要 12 个文件?内存放不下时,就需要使用外部排序,外部排序一般使用归并排序算法。可以这么简单理解,MySQL 将需要排序的数据分成 12 份,每一份单独排序后存在这些临时文件中。然后把这 12 个有序文件再合并成一个有序的大文件。
如果 sort_buffer_size 超过了需要排序的数据量的大小,number_of_tmp_files 就是 0,表示排序可以直接在内存中完成。
否则就需要放在临时文件中排序。sort_buffer_size 越小,需要分成的份数越多,number_of_tmp_files 的值就越大。
接下来,我再和你解释一下图 4 中其他两个值的意思。
我们的示例表中有 4000 条满足 city='杭州’的记录,所以你可以看到examined_rows=4000,表示参与排序的行数是 4000 行。
sort_mode 里面的 packed_additional_fields 的意思是,排序过程对字符串做了“紧凑”处理。即使 name 字段的定义是 varchar(16),在排序过程中还是要按照实际长度来分配空间的。
同时,最后一个查询语句 select @b-@a 的返回结果是 4000,表示整个执行过程只扫描了4000 行。
这里需要注意的是,为了避免对结论造成干扰,我把 internal_tmp_disk_storage_engine 设置成 MyISAM。否则,select @b-@a 的结果会显示为 4001。
这是因为查询 OPTIMIZER_TRACE 这个表时,需要用到临时表,而 internal_tmp_disk_storage_engine 的默认值是 InnoDB。如果使用的是 InnoDB 引擎的话,把数据从临时表取出来的时候,会让 Innodb_rows_read 的值加 1。
rowid 排序
在上面这个算法过程里面,只对原表的数据读了一遍,剩下的操作都是在 sort_buffer 和临时文件中执行的。但这个算法有一个问题,就是如果查询要返回的字段很多的话,那么 sort_buffer里面要放的字段数太多,这样内存里能够同时放下的行数很少,要分成很多个临时文件,排序的性能会很差。
所以如果单行很大,这个方法效率不够好。
那么,如果 MySQL 认为排序的单行长度太大会怎么做呢?
接下来,我来修改一个参数,让 MySQL 采用另外一种算法。
SET max_length_for_sort_data = 16;max_length_for_sort_data,是 MySQL 中专门控制用于排序的行数据的长度的一个参数。它的意思是,如果单行的长度超过这个值,MySQL 就认为单行太大,要换一个算法。
city、name、age 这三个字段的定义总长度是 24,我把 max_length_for_sort_data 设置为16,我们再来看看计算过程有什么改变。
新的算法放入 sort_buffer 的字段,只有要排序的列(即 name 字段)和主键 id。
但这时,排序的结果就因为少了 city 和 age 字段的值,不能直接返回了,整个执行流程就变成如下所示的样子:
- 初始化 sort_buffer,确定放入两个字段,即 name 和 id;
- 从索引 city 找到第一个满足 city='杭州’条件的主键 id,也就是图中的 ID_X;
- 到主键 id 索引取出整行,取 name、id 这两个字段,存入 sort_buffer 中;
- 从索引 city 取下一个记录的主键 id;
- 重复步骤 3、4 直到不满足 city='杭州’条件为止,也就是图中的 ID_Y;
- 对 sort_buffer 中的数据按照字段 name 进行排序;
- 遍历排序结果,取前 1000 行,并按照 id 的值回到原表中取出 city、name 和 age 三个字段返回给客户端。
这个执行流程的示意图如下,我把它称为 rowid 排序。
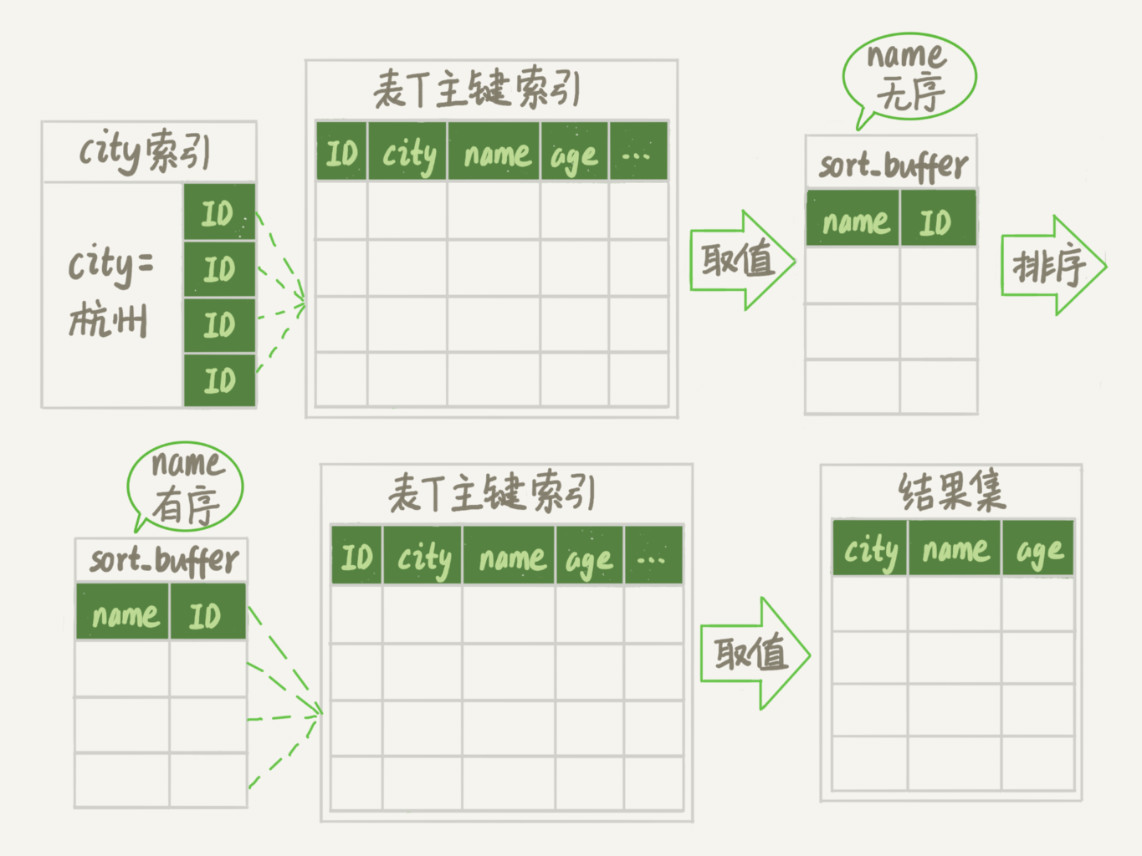
对比图 3 的全字段排序流程图你会发现,rowid 排序多访问了一次表 t 的主键索引,就是步骤7。
需要说明的是,最后的“结果集”是一个逻辑概念,实际上 MySQL 服务端从排序后的sort_buffer 中依次取出 id,然后到原表查到 city、name 和 age 这三个字段的结果,不需要在服务端再耗费内存存储结果,是直接返回给客户端的。
根据这个说明过程和图示,你可以想一下,这个时候执行 select @b-@a,结果会是多少呢?
现在,我们就来看看结果有什么不同。
首先,图中的 examined_rows 的值还是 4000,表示用于排序的数据是 4000 行。但是 select @b-@a 这个语句的值变成 5000 了。
因为这时候除了排序过程外,在排序完成后,还要根据 id 去原表取值。由于语句是 limit 1000,因此会多读 1000 行
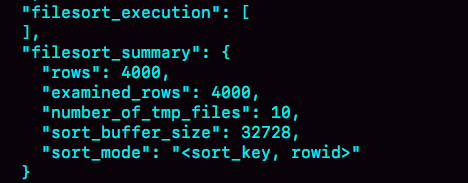
从 OPTIMIZER_TRACE 的结果中,你还能看到另外两个信息也变了。
sort_mode 变成了 <sort_key, rowid>,表示参与排序的只有 name 和 id 这两个字段。
number_of_tmp_files 变成 10 了,是因为这时候参与排序的行数虽然仍然是 4000 行,但是每一行都变小了,因此需要排序的总数据量就变小了,需要的临时文件也相应地变少了。
全字段排序 VS rowid 排序
我们来分析一下,从这两个执行流程里,还能得出什么结论。
如果 MySQL 实在是担心排序内存太小,会影响排序效率,才会采用 rowid 排序算法,这样排序过程中一次可以排序更多行,但是需要再回到原表去取数据。
如果 MySQL 认为内存足够大,会优先选择全字段排序,把需要的字段都放到 sort_buffer 中,
这样排序后就会直接从内存里面返回查询结果了,不用再回到原表去取数据。
这也就体现了 MySQL 的一个设计思想:如果内存够,就要多利用内存,尽量减少磁盘访问。
对于 InnoDB 表来说,rowid 排序会要求回表多造成磁盘读,因此不会被优先选择。
这个结论看上去有点废话的感觉,但是你要记住它,下一篇文章我们就会用到。
看到这里,你就了解了,MySQL 做排序是一个成本比较高的操作。那么你会问,是不是所有的 order by 都需要排序操作呢?如果不排序就能得到正确的结果,那对系统的消耗会小很多,语句的执行时间也会变得更短。
其实,并不是所有的 order by 语句,都需要排序操作的。从上面分析的执行过程,我们可以看到,MySQL 之所以需要生成临时表,并且在临时表上做排序操作,其原因是原来的数据都是无序的。
你可以设想下,如果能够保证从 city 这个索引上取出来的行,天然就是按照 name 递增排序的话,是不是就可以不用再排序了呢?
确实是这样的。
所以,我们可以在这个市民表上创建一个 city 和 name 的联合索引,对应的 SQL 语句是:
alter table t add index city_user(city, name);作为与 city 索引的对比,我们来看看这个索引的示意图。
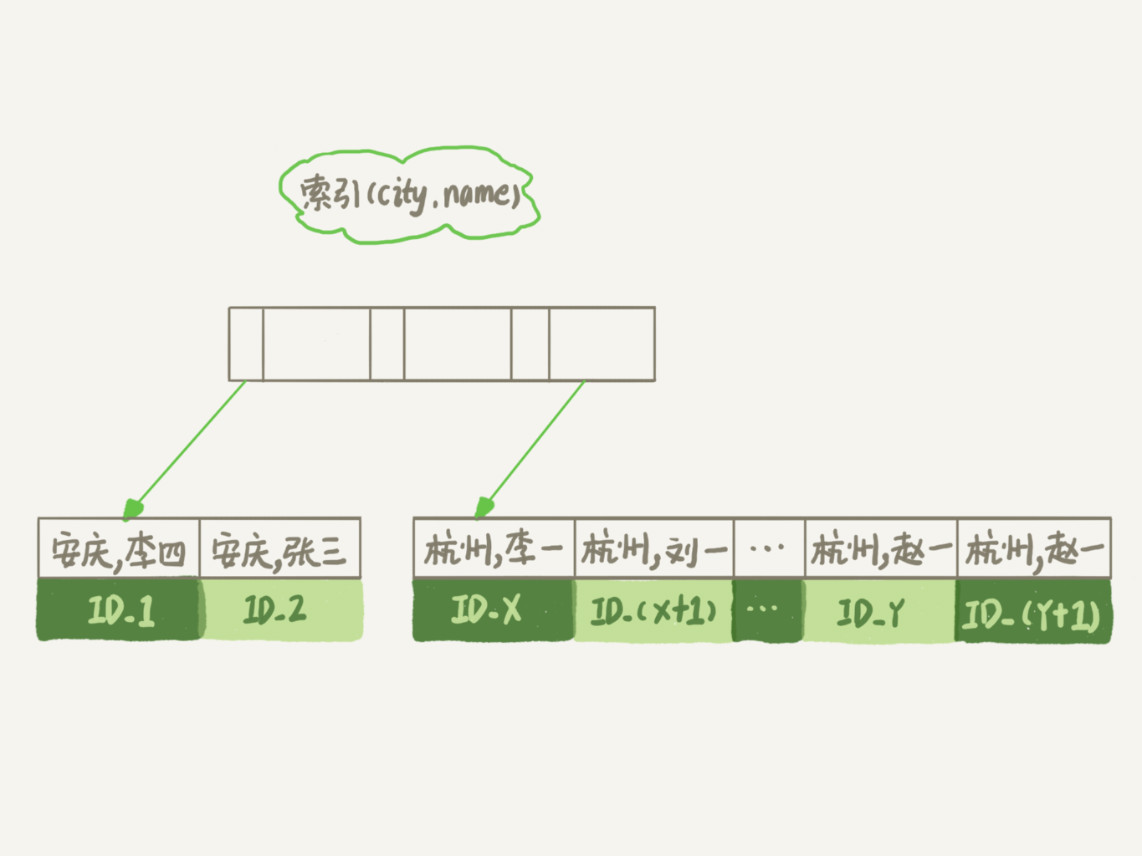
在这个索引里面,我们依然可以用树搜索的方式定位到第一个满足 city='杭州’的记录,并且额外确保了,接下来按顺序取“下一条记录”的遍历过程中,只要 city 的值是杭州,name 的值就一定是有序的。
这样整个查询过程的流程就变成了:
- 从索引 (city,name) 找到第一个满足 city='杭州’条件的主键 id;
- 到主键 id 索引取出整行,取 name、city、age 三个字段的值,作为结果集的一部分直接返回;
- 从索引 city 取下一个记录主键 id;
- 重复步骤 2、3,直到查到第 1000 条记录,或者是不满足 city='杭州’条件时循环结束。
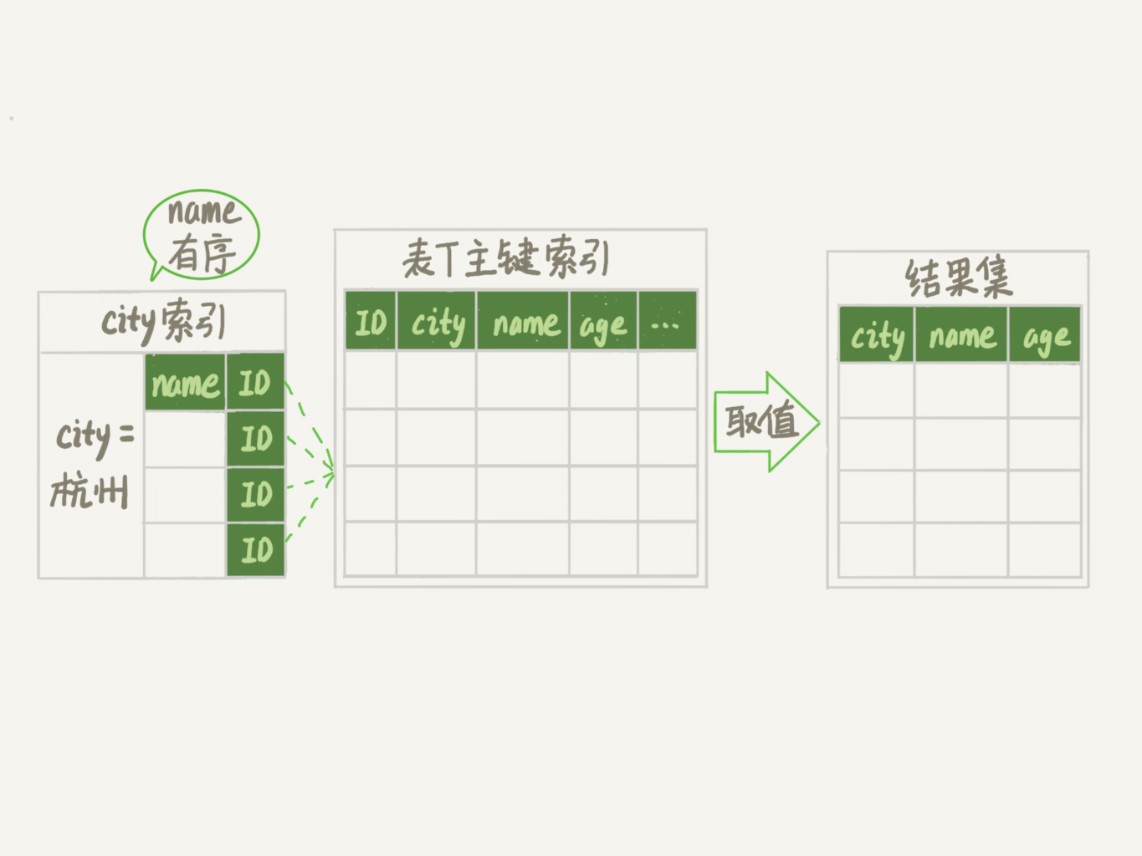
可以看到,这个查询过程不需要临时表,也不需要排序。接下来,我们用 explain 的结果来印证一下。

从图中可以看到,Extra 字段中没有 Using filesort 了,也就是不需要排序了。而且由于(city,name) 这个联合索引本身有序,所以这个查询也不用把 4000 行全都读一遍,只要找到满足条件的前 1000 条记录就可以退出了。也就是说,在我们这个例子里,只需要扫描 1000 次。
既然说到这里了,我们再往前讨论,**这个语句的执行流程有没有可能进一步简化呢?**不知道你还记不记得,我在第 5 篇文章《 深入浅出索引(下)》中,和你介绍的覆盖索引。
这里我们可以再稍微复习一下。覆盖索引是指,索引上的信息足够满足查询请求,不需要再回到主键索引上去取数据。
按照覆盖索引的概念,我们可以再优化一下这个查询语句的执行流程。
针对这个查询,我们可以创建一个 city、name 和 age 的联合索引,对应的 SQL 语句就是:
alter table t add index city_user_age(city, name, age);这时,对于 city 字段的值相同的行来说,还是按照 name 字段的值递增排序的,此时的查询语句也就不再需要排序了。这样整个查询语句的执行流程就变成了:
- 从索引 (city,name,age) 找到第一个满足 city='杭州’条件的记录,取出其中的 city、name 和 age 这三个字段的值,作为结果集的一部分直接返回;
- 从索引 (city,name,age) 取下一个记录,同样取出这三个字段的值,作为结果集的一部分直接返回;
- 重复执行步骤 2,直到查到第 1000 条记录,或者是不满足 city='杭州’条件时循环结束。
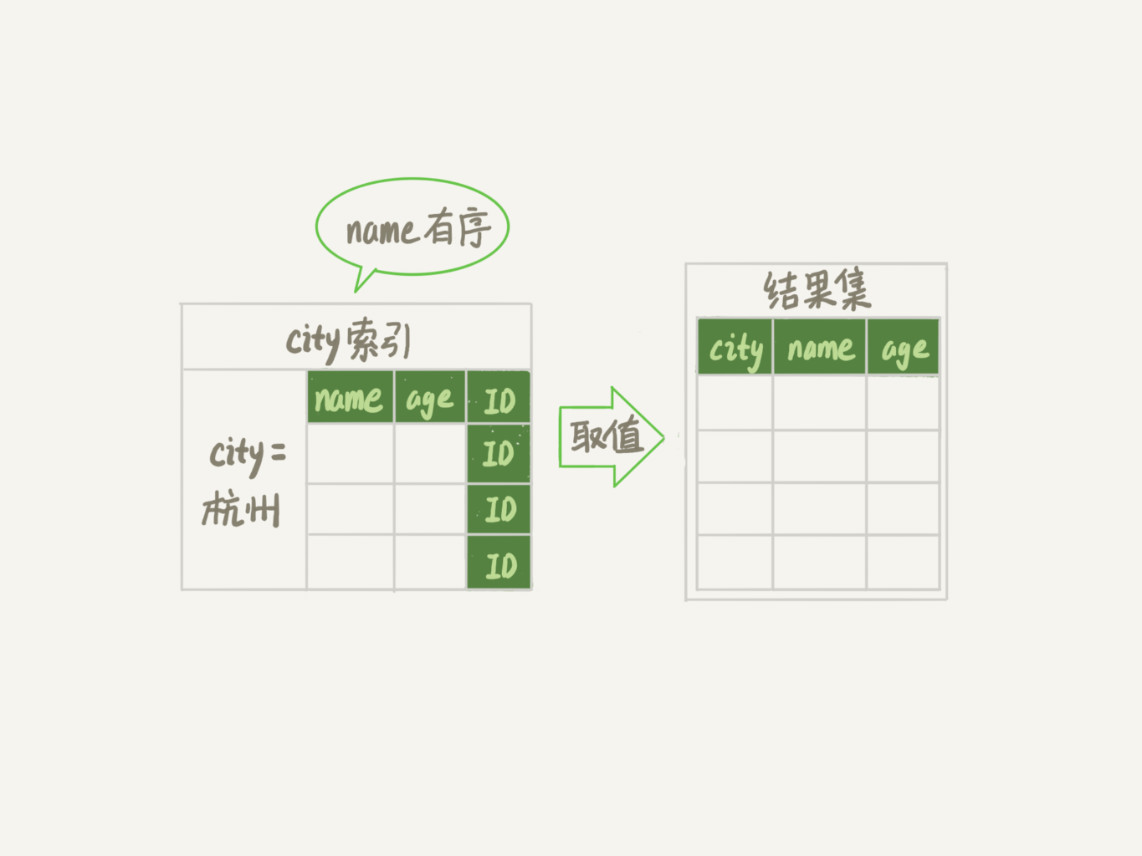
然后,我们再来看看 explain 的结果。

可以看到,Extra 字段里面多了“Using index”,表示的就是使用了覆盖索引,性能上会快很多。
当然,这里并不是说要为了每个查询能用上覆盖索引,就要把语句中涉及的字段都建上联合索引,毕竟索引还是有维护代价的。这是一个需要权衡的决定。
小结
今天这篇文章,我和你介绍了 MySQL 里面 order by 语句的几种算法流程。
在开发系统的时候,你总是不可避免地会使用到 order by 语句。你心里要清楚每个语句的排序逻辑是怎么实现的,还要能够分析出在最坏情况下,每个语句的执行对系统资源的消耗,这样才能做到下笔如有神,不犯低级错误
最后,我给你留下一个思考题吧。
假设你的表里面已经有了 city_name(city, name) 这个联合索引,然后你要查杭州和苏州两个城市中所有的市民的姓名,并且按名字排序,显示前 100 条记录。如果 SQL 查询语句是这么写的。
mysql> select * from t where city in ('杭州'," 苏州 ") order by name limit 100;那么,这个语句执行的时候会有排序过程吗,为什么?
如果业务端代码由你来开发,需要实现一个在数据库端不需要排序的方案,你会怎么实现呢?
进一步地,如果有分页需求,要显示第 101 页,也就是说语句最后要改成 “limit 10000,100”, 你的实现方法又会是什么呢?
你可以把你的思考和观点写在留言区里,我会在下一篇文章的末尾和你讨论这个问题。感谢你的收听,也欢迎你把这篇文章分享给更多的朋友一起阅读。
上期问题时间
上期的问题是,当 MySQL 去更新一行,但是要修改的值跟原来的值是相同的,这时候 MySQL 会真的去执行一次修改吗?还是看到值相同就直接返回呢?
这是第一次我们课后问题的三个选项都有同学选的,所以我要和你需要详细说明一下。
第一个选项是,MySQL 读出数据,发现值与原来相同,不更新,直接返回,执行结束。这里我们可以用一个锁实验来确认。
假设,当前表 t 里的值是 (1,2)。
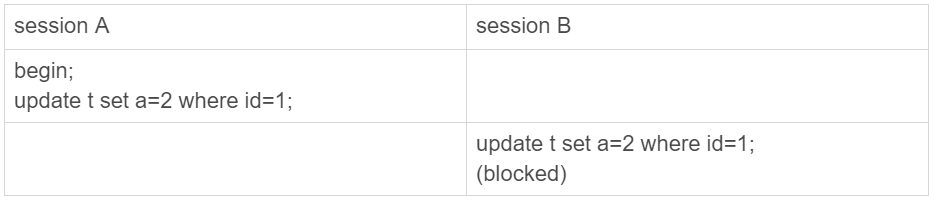
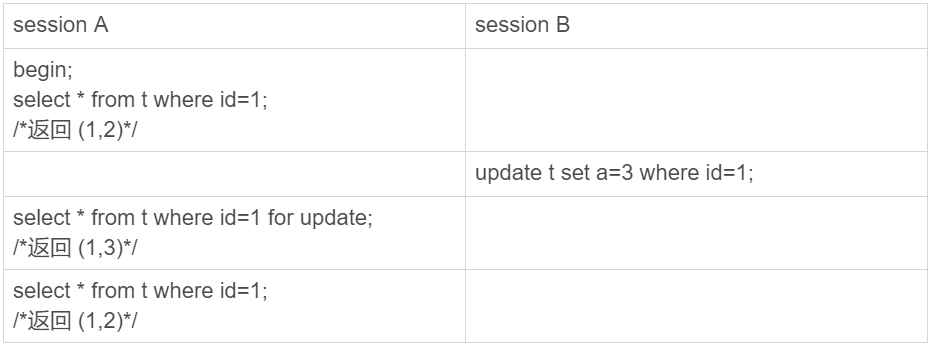
第二个选项是,MySQL 调用了 InnoDB 引擎提供的接口,但是引擎发现值与原来相同,不更新,直接返回。有没有这种可能呢?这里我用一个可见性实验来确认。
假设当前表里的值是 (1,2)。
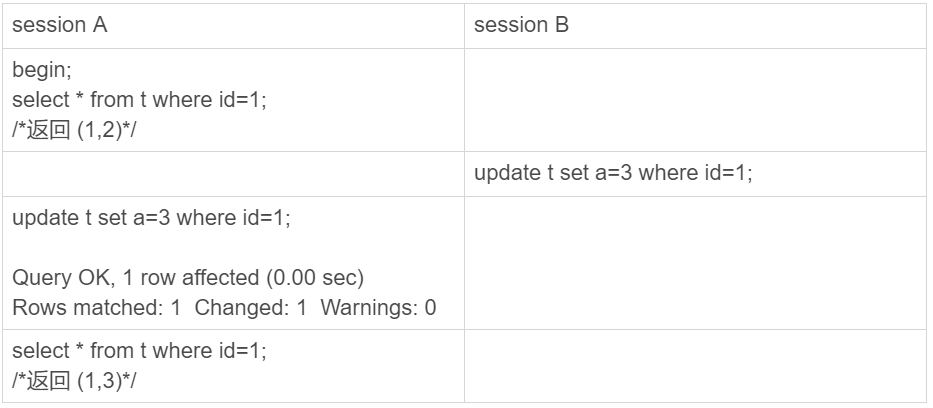
session A 的第二个 select 语句是一致性读(快照读),它是不能看见 session B 的更新的。
现在它返回的是 (1,3),表示它看见了某个新的版本,这个版本只能是 session A 自己的 update 语句做更新的时候生成。(如果你对这个逻辑有疑惑的话,可以回顾下第 8 篇文章《事务到底是隔离的还是不隔离的?》中的相关内容)
所以,我们上期思考题的答案应该是选项 3,即:InnoDB 认真执行了“把这个值修改成(1,2)"这个操作,该加锁的加锁,该更新的更新。
然后你会说,MySQL 怎么这么笨,就不会更新前判断一下值是不是相同吗?如果判断一下,不就不用浪费 InnoDB 操作,多去更新一次了?
其实 MySQL 是确认了的。只是在这个语句里面,MySQL 认为读出来的值,只有一个确定的(id=1), 而要写的是 (a=3),只从这两个信息是看不出来“不需要修改”的。
作为验证,你可以看一下下面这个例子。
评论区留言点赞板:
@Gavin 、@melon、@阿建 等同学提到了锁验证法;
@郭江伟 同学提到了两个点,都非常好,有去实际验证。结论是这样的
第一,hexdump 看出来没改应该是 WAL 机制生效了,要过一会儿,或者把库
shutdown 看看。
第二,binlog 没写是 MySQL Server 层知道行的值没变,所以故意不写的,这个
是在 row 格式下的策略。你可以把 binlog_format 改成 statement 再验证下。
@mahonebags 同学提到了 timestamp 字段的问题,打中了我的知识盲点。今
天现翻代码才补上了,多谢啦。结论是:如果表中有 timestamp 字段而且设置了
自动更新,那么更新“别的字段”的时候,MySQL 会读入所有涉及的字段,这样
通过判断,发现不需要修改。这个点我会在后面讲更新性能的文章中再展开。
Q&A
老师,基于早上知道的sort_buffer是在server层,我重新理解了下rowid排序的过程,
1,执行器查看表定义,发现name、city、age字段的长度之和超过max_length_for_sort_data,所以初始化sort_buffer的时候只放入id和name字段。
2,执行器调用存储引擎的读数据接口,依次获取满足条件的数据的id和name,存入sort_buffer。
3,排序。
4,执行器根据limit条件筛选出id,再次调用引擎读数据的接口获取相应的数据,返回客户端。
整个过程实际上是被执行器拆成了两次查询,共调用两次存储层的读数据接口,所以总的扫描行数需要相加。(@b-@a=5000)
但是对于using index condition的场景,执行器只调用了一次查询接口,回表是由存储层来完成的,所以扫描行数只算一次,即只算走索引搜索的过程中扫描的行数。(@b-@a只会是4000)
不知道这么理解对不对?
不仅对,而且非常好!👍👍
把两个知识点连起来了。是的:
1.rows_examined就是“server层调用引擎取一行的时候”加1;
2.引擎内部自己调用,读取行,不加1;
再补充一个例子:
加索引的时候,也要扫描全表,但如果是inplace DDL(@第13篇),你会看到扫描行数是0,也是因为这些扫描动作都是引擎内部自己调用的。
re: 问题3:回答得也很好,需要注意的是255这个边界。小于255都需要一个字节记录长度,超过255就需要两个字节
11 月过数据库设计方案,总监现场抛了一个问题,就是关于 varchar 255 的。现在回看,木有人回答到点上,都说是历史原因。
下回再问,就可以分享这一点了。ꉂ ೭(˵¯̴͒ꇴ¯̴͒˵)౨”哇哈哈~
最怕的回答“历史原因”、“大家都这么做的所以…”、“别人要求的” 😄
回答下@发条橙子同学的问题:
问题一:
1)无条件查询如果只有order by create_time,即便create_time上有索引,也不会使用到。
因为优化器认为走二级索引再去回表成本比全表扫描排序更高。
所以选择走全表扫描,然后根据老师讲的两种方式选择一种来排序
2)无条件查询但是是order by create_time limit m.如果m值较小,是可以走索引的.
因为优化器认为根据索引有序性去回表查数据,然后得到m条数据,就可以终止循环,那么成本比全表扫描小,则选择走二级索引。
即便没有二级索引,mysql针对order by limit也做了优化,采用堆排序。这部分老师明天会讲
问题二:
如果是group by a,a上不能使用索引的情况,是走rowid排序。
如果是group by limit,不能使用索引的情况,是走堆排序
如果是只有group by a,a上有索引的情况,又根据选取值不同,索引的扫描方式又有不同
select * from t group by a --走的是索引全扫描,至于这里为什么选择走索引全扫描,还需要老师解惑下
select a from t group by a --走的是索引松散扫描,也就说只需要扫描每组的第一行数据即可,不用扫描每一行的值
问题三:
bigint和int加数字都不影响能存储的值。
bigint(1)和bigint(19)都能存储2^64-1范围内的值,int是2^32-1。只是有些前端会根据括号里来截取显示而已。建议不加varchar()就必须带,因为varchar()括号里的数字代表能存多少字符。假设varchar(2),就只能存两个字符,不管是中文还是英文。目前来看varchar()这个值可以设得稍稍大点,因为内存是按照实际的大小来分配内存空间的,不是按照值来预分配的。
老师我有几个问题:
1.我还是想在确认之前问的问题。一个长连接,一条sql申请了sort_buffer_size等一系列的会话级别的内存,sql成功执行完,该连接变为sleep状态。这些内存只是内容会被情况,但是占用的内存空间不会释放?
2.假设要给a值加1,执行器先找引擎取a=1的行,然后执行器给a+1,在调用接口写入a+1了数据。那么加锁不应该是在执行器第一次去取数据时,引擎层就加该加的锁?为什么要等到第二次调用写入数据时,才加锁。第一次和第二次之间,难道不会被其他事务修改吗?如果没有锁保证
3.始终没太明白堆排序是采用的什么算法使得只需要对limit的数据进行排序就可以,而不是排序所有的数据在取前m条。--不过这里期待明天的文章
发条橙子同学的问题:
问题1:你回答得比我回复的答案还好!👍🏿
问题2:这个后面我们展开哈,要配图才能说得清😄
问题3:回答得也很好,需要注意的是255这个边界。小于255都需要一个字节记录长度,超过255就需要两个字节
你的问题:#好问题_#
1.排序相关的内存在排序后就free掉还给系统了
2.读的时候加了写锁的
3.堆排序要读所有行的,只读一次,我估计你已经理解对了😄
刚才又测了一下,在binlog-row-image=full的情况下,第二次update是不写redolog的,说明update并没有发生
这样我就理解了,当full时,mysql需要读到在更新时读到a值,所以会判断a值不变,不需要更新,与你给出的update t set a=3 where id=1 and a=3原理相同,但binlog-row-image会影响查询结果还是会让人吃一惊
是的。
这个我也盲点了。
但是细想MySQL 选择这个策略又是合理的。
我需要再更新一下专栏内容
关于上期问题里的最后一个例子不太明白,还请老师指点一下。按说在更新操作的时候应该是当前读,那么应该能读到id=1 and a = 3的记录并修改。那么为什么再select还会查到a = 2。难道是即便update但是where条件也是快照读?但是如果这样那么幻读的问题不就不会存在了吗?(B insert了一条记录,此时A范围update后再select会把B insert的语句查出来)
是说图14这里对吧,
这里update语句自己是当前读,但是它没有更新数据;
所以之后的查询还是看不到(1,3)这个版本。
好问题👍
不好意思,上个留言没打完。
问题一,在跟max_length_for_sort_data坐比较时,mysql是怎么判断一行数据的大小的?是直接根据表定义字段的大小吗?
问题二,另外这‘一行’的含义是整行数据,还是单单最终引擎层需要返回的字段(即select字段+where字段+order by字段)?
麻烦老师有空解答下,谢谢哈
1.需要的字段的定义大小的和
2.好问题。首先取决于使用的算法。
a) 如果是全字段排序就是select字段+where字段+order by字段,
b) 如果是row_id排序,就是order by字段+row_id
请教下林老师:
以文章中的 t 表,索引 city(city) 其实等价于 city(city, id) ,第2条语句加了 order by id,Extra 列多了 Using where ,为啥还要这个??两个都是用到了覆盖索引。
mysql> explain select id from t where city = 'city102' limit 1, 10;
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref   | rows | filtered | Extra       |
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+-------------+
|  1 | SIMPLE      | t     | NULL       | ref  | city          | city | 66      | const |    2 |   100.00 | Using index |
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)

mysql> explain select id from t where city = 'city102' order by id limit 1, 10;
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+--------------------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref   | rows | filtered | Extra                    |
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+--------------------------+
|  1 | SIMPLE      | t     | NULL       | ref  | city          | city | 66      | const |    2 |   100.00 | Using where; Using index |
+----+-------------+-------+------------+------+---------------+------+---------+-------+------+----------+--------------------------+
1 row in set, 1 warning (0.00 sec)
Using where 确实是一个有时候让人误解的Extra信息,我后面看看找个文章展开说明哈
简单说就是,Using where包含了一个“值比较”的过程。
好问题
老师你好,全字段排序那一节,我做了实验,我的排序缓存大小是1M, examined rows 是7715892,查询的三个字段都有数据,那么如果这些数据都放到缓存应该需要(4+8+11)*7715892等于160M,但是我看了都没有用到临时表,这是为什么?
CREATE TABLE `phone_call_logs` (
`id` int(11) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID',
`city_id` int(11) NOT NULL DEFAULT '11',
`call_sender` varchar(40) DEFAULT NULL COMMENT '电话主叫号码',
`phone_id` bigint(20) NOT NULL DEFAULT '0' COMMENT '手机id',
PRIMARY KEY (`id`),
KEY `idx_city` (`city_id`)
) ENGINE=InnoDB AUTO_INCREMENT=64551193;
----------------sort_buffer_size=1M----------------------------
root:(none)> show variables like 'sort_buffer_size';
+------------------+---------+
| Variable_name    | Value   |
+------------------+---------+
| sort_buffer_size | 1048576 |
+------------------+---------+
1 row in set (0.00 sec)
---------------查询sql---------------------
select city_id,phone_id,call_sender from phone_call_logs where city_id=11 order by phone_id desc limit 1000;
-----------------------执行计划结果---------------------------------------------
"filesort_priority_queue_optimization": {
"limit": 1000,
"rows_estimate": 146364461,
"row_size": 146,
"memory_available": 1048576,
"chosen": true
},
"filesort_execution": [
],
"filesort_summary": {
"rows": 1001,
"examined_rows": 7715892,
"number_of_tmp_files": 0,
"sort_buffer_size": 154160,
"sort_mode": "<sort_key, additional_fields>"
好问题,明天见 😁
(明天的一篇也是跟排序有关的哦)
老师我想问一下 mysql在做没有排序的查询语句的时候 每次扫描返回的结果集顺序一样吗?还是每次扫描的结果集顺序是变化的?
要看使用的索引有没有变化,
是按照索引顺序的
思维导图(AI生成)