19 | 为什么我只查一行的语句,也执行这么慢?
一般情况下,如果我跟你说查询性能优化,你首先会想到一些复杂的语句,想到查询需要返回大量的数据。但有些情况下,“查一行”,也会执行得特别慢。今天,我就跟你聊聊这个有趣的话题,看看什么情况下,会出现这个现象。
需要说明的是,如果 MySQL 数据库本身就有很大的压力,导致数据库服务器 CPU 占用率很高或 ioutil(IO 利用率)很高,这种情况下所有语句的执行都有可能变慢,不属于我们今天的讨
论范围。
为了便于描述,我还是构造一个表,基于这个表来说明今天的问题。这个表有两个字段 id 和 c,并且我在里面插入了 10 万行记录。
mysql> CREATE TABLE `t` (
    `id` int(11) NOT NULL,
    `c` int(11) DEFAULT NULL,
    PRIMARY KEY (`id`)
) ENGINE=InnoDB;
delimiter ;;
create procedure idata()
begin
    declare i int;
    set i=1;
    while(i<=100000)do
    insert into t values(i,i)
    set i=i+1;
end while;
end;;
delimiter ;
call idata();
接下来,我会用几个不同的场景来举例,有些是前面的文章中我们已经介绍过的知识点,你看看能不能一眼看穿,来检验一下吧。
第一类:查询长时间不返回
如图 1 所示,在表 t 执行下面的 SQL 语句:
mysql> select * from t where id=1;查询结果长时间不返回。

一般碰到这种情况的话,大概率是表 t 被锁住了。接下来分析原因的时候,一般都是首先执行一下 show processlist 命令,看看当前语句处于什么状态。
然后我们再针对每种状态,去分析它们产生的原因、如何复现,以及如何处理。
等 MDL 锁
如图 2 所示,就是使用 show processlist 命令查看 Waiting for table metadata lock 的示意图。
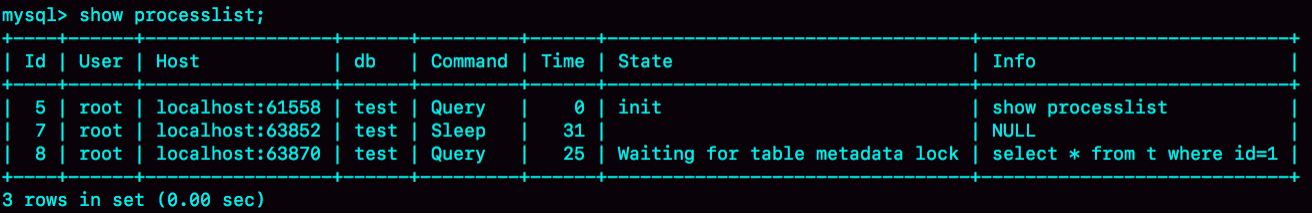
出现这个状态表示的是,现在有一个线程正在表 t 上请求或者持有 MDL 写锁,把 select 语句堵住了。
在第 6 篇文章《全局锁和表锁 :给表加个字段怎么有这么多阻碍?》中,我给你介绍过一种复现方法。但需要说明的是,那个复现过程是基于 MySQL 5.6 版本的。而 MySQL 5.7 版本修改了 MDL 的加锁策略,所以就不能复现这个场景了。
不过,在 MySQL 5.7 版本下复现这个场景,也很容易。如图 3 所示,我给出了简单的复现步骤。
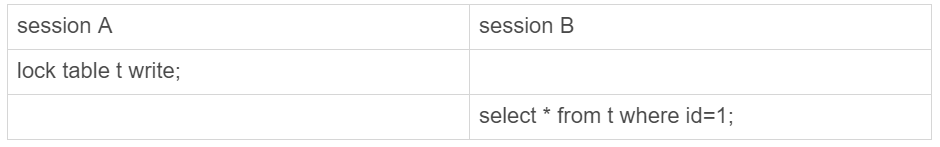
session A 通过 lock table 命令持有表 t 的 MDL 写锁,而 session B 的查询需要获取 MDL 读锁。所以,session B 进入等待状态。
这类问题的处理方式,就是找到谁持有 MDL 写锁,然后把它 kill 掉。
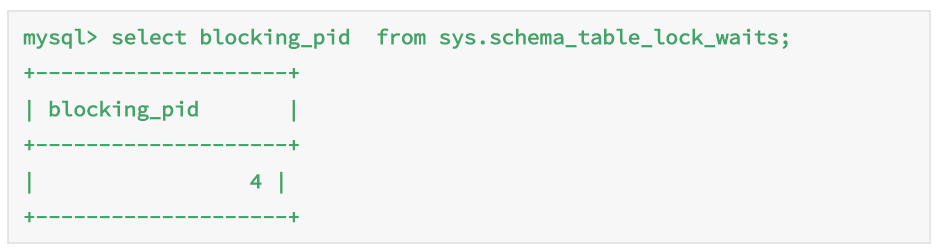
但是,由于在 show processlist 的结果里面,session A 的 Command 列是“Sleep”,导致查找起来很不方便。不过有了 performance_schema 和 sys 系统库以后,就方便多了。
通过查询 sys.schema_table_lock_waits 这张表,我们就可以直接找出造成阻塞的 process id,把这个连接用 kill 命令断开即可。
等 flush
接下来,我给你举另外一种查询被堵住的情况。
我在表 t 上,执行下面的 SQL 语句:
mysql> select * from information_schema.processlist where id=6;这里,我先卖个关子。
你可以看一下图 5。我查出来这个线程的状态是 Waiting for table flush,你可以设想一下这是什么原因。
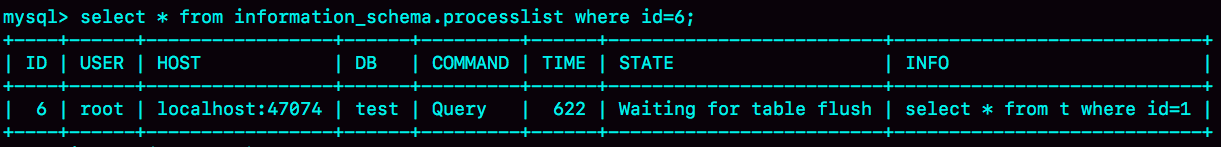
这个状态表示的是,现在有一个线程正要对表 t 做 flush 操作。MySQL 里面对表做 flush 操作的用法,一般有以下两个:
flush tables t with read lock;
flush tables with read lock;
这两个 flush 语句,如果指定表 t 的话,代表的是只关闭表 t;如果没有指定具体的表名,则表示关闭 MySQL 里所有打开的表。
但是正常这两个语句执行起来都很快,除非它们也被别的线程堵住了。
所以,出现 Waiting for table flush 状态的可能情况是:有一个 flush tables 命令被别的语句堵住了,然后它又堵住了我们的 select 语句。
现在,我们一起来复现一下这种情况,复现步骤如图 6 所示:
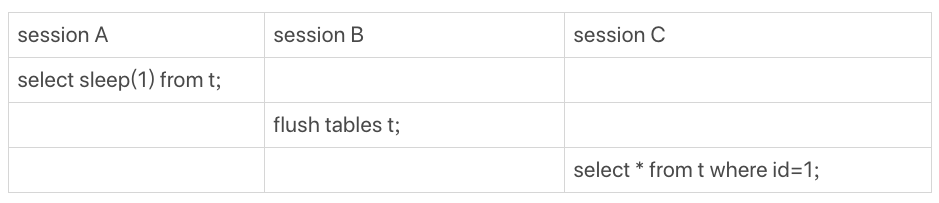
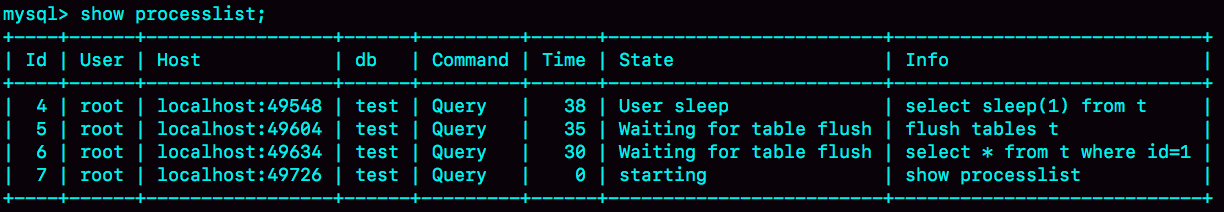
在 session A 中,我故意每行都调用一次 sleep(1),这样这个语句默认要执行 10 万秒,在这期间表 t 一直是被 session A“打开”着。然后,session B 的 flush tables t 命令再要去关闭表t,就需要等 session A 的查询结束。这样,session C 要再次查询的话,就会被 flush 命令堵住了。
图 7 是这个复现步骤的 show processlist 结果。这个例子的排查也很简单,你看到这个 show processlist 的结果,肯定就知道应该怎么做了。
等行锁
现在,经过了表级锁的考验,我们的 select 语句终于来到引擎里了。
mysql> select * from t where id=1 lock in share mode;上面这条语句的用法你也很熟悉了,我们在第 8 篇《事务到底是隔离的还是不隔离的?》文章介绍当前读时提到过。
由于访问 id=1 这个记录时要加读锁,如果这时候已经有一个事务在这行记录上持有一个写锁,我们的 select 语句就会被堵住。
复现步骤和现场如下:
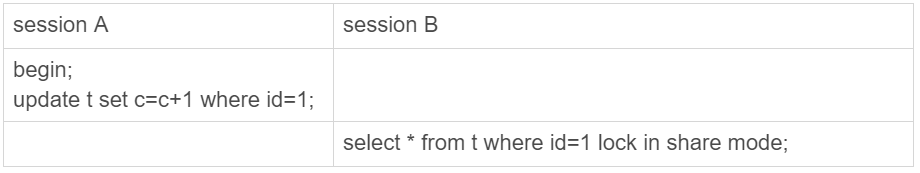
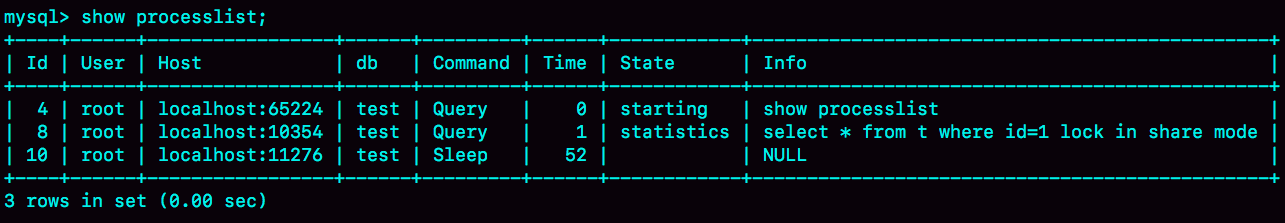
显然,session A 启动了事务,占有写锁,还不提交,是导致 session B 被堵住的原因。
这个问题并不难分析,但问题是怎么查出是谁占着这个写锁。如果你用的是 MySQL 5.7 版本,可以通过 sys.innodb_lock_waits 表查到。
查询方法是:
mysql> select * from t sys.innodb_lock_waits where locked_table=`'test'.'t'`\G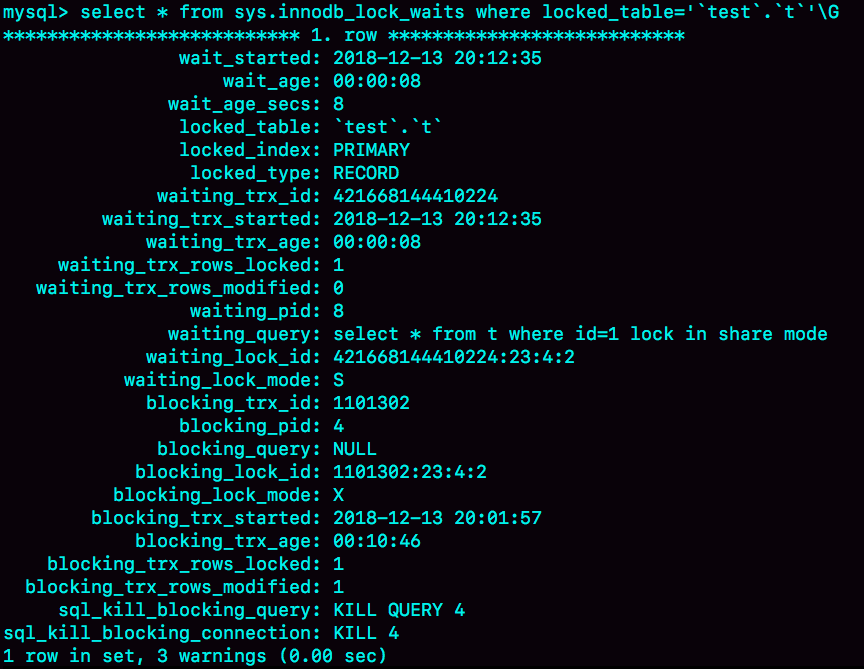
可以看到,这个信息很全,4 号线程是造成堵塞的罪魁祸首。而干掉这个罪魁祸首的方式,就是 KILL QUERY 4 或 KILL 4。
不过,这里不应该显示“KILL QUERY 4”。这个命令表示停止 4 号线程当前正在执行的语句,而这个方法其实是没有用的。因为占有行锁的是 update 语句,这个语句已经是之前执行完成了的,现在执行 KILL QUERY,无法让这个事务去掉 id=1 上的行锁。
实际上,KILL 4 才有效,也就是说直接断开这个连接。这里隐含的一个逻辑就是,连接被断开的时候,会自动回滚这个连接里面正在执行的线程,也就释放了 id=1 上的行锁。
第二类:查询慢
经过了重重封“锁”,我们再来看看一些查询慢的例子。
先来看一条你一定知道原因的 SQL 语句:
mysql> select * from t where c=50000 limit 1;由于字段 c 上没有索引,这个语句只能走 id 主键顺序扫描,因此需要扫描 5 万行。
作为确认,你可以看一下慢查询日志。注意,这里为了把所有语句记录到 slow log 里,我在连接后先执行了 set long_query_time=0,将慢查询日志的时间阈值设置为 0。
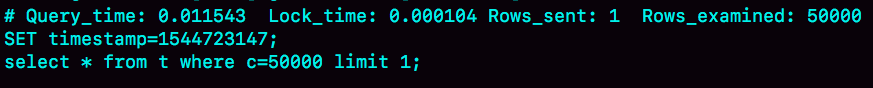
Rows_examined 显示扫描了 50000 行。你可能会说,不是很慢呀,11.5 毫秒就返回了,我们线上一般都配置超过 1 秒才算慢查询。但你要记住:坏查询不一定是慢查询。我们这个例子里面只有 10 万行记录,数据量大起来的话,执行时间就线性涨上去了。
扫描行数多,所以执行慢,这个很好理解。
但是接下来,我们再看一个只扫描一行,但是执行很慢的语句。
如图 12 所示,是这个例子的 slow log。可以看到,执行的语句是
mysql> select * from t where id=1;虽然扫描行数是 1,但执行时间却长达 800 毫秒。

是不是有点奇怪呢,这些时间都花在哪里了?
如果我把这个 slow log 的截图再往下拉一点,你可以看到下一个语句,select * from t where id=1 lock in share mode,执行时扫描行数也是 1 行,执行时间是 0.2 毫秒。

看上去是不是更奇怪了?按理说 lock in share mode 还要加锁,时间应该更长才对啊。
可能有的同学已经有答案了。如果你还没有答案的话,我再给你一个提示信息,图 14 是这两个语句的执行输出结果。
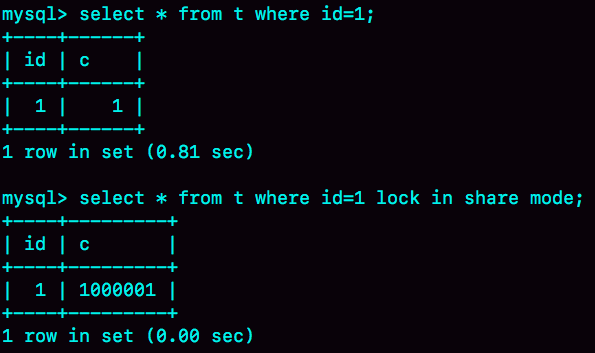
第一个语句的查询结果里 c=1,带 lock in share mode 的语句返回的是 c=1000001。看到这里应该有更多的同学知道原因了。如果你还是没有头绪的话,也别着急。我先跟你说明一下复现步骤,再分析原因。
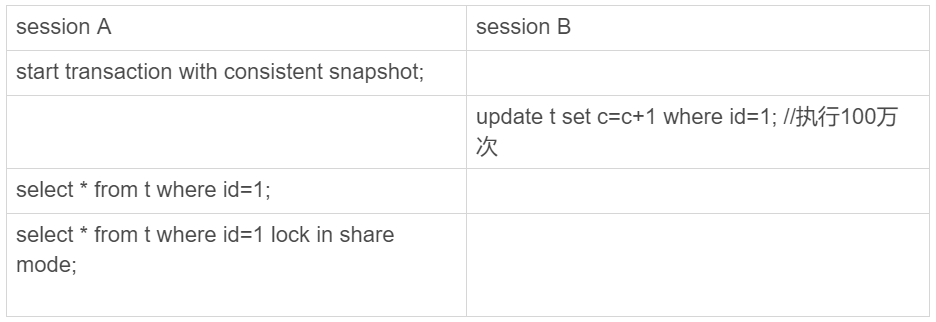
你看到了,session A 先用 start transaction with consistent snapshot 命令启动了一个事务,之后 session B 才开始执行 update 语句。
session B 执行完 100 万次 update 语句后,id=1 这一行处于什么状态呢?你可以从图 16 中找到答案。
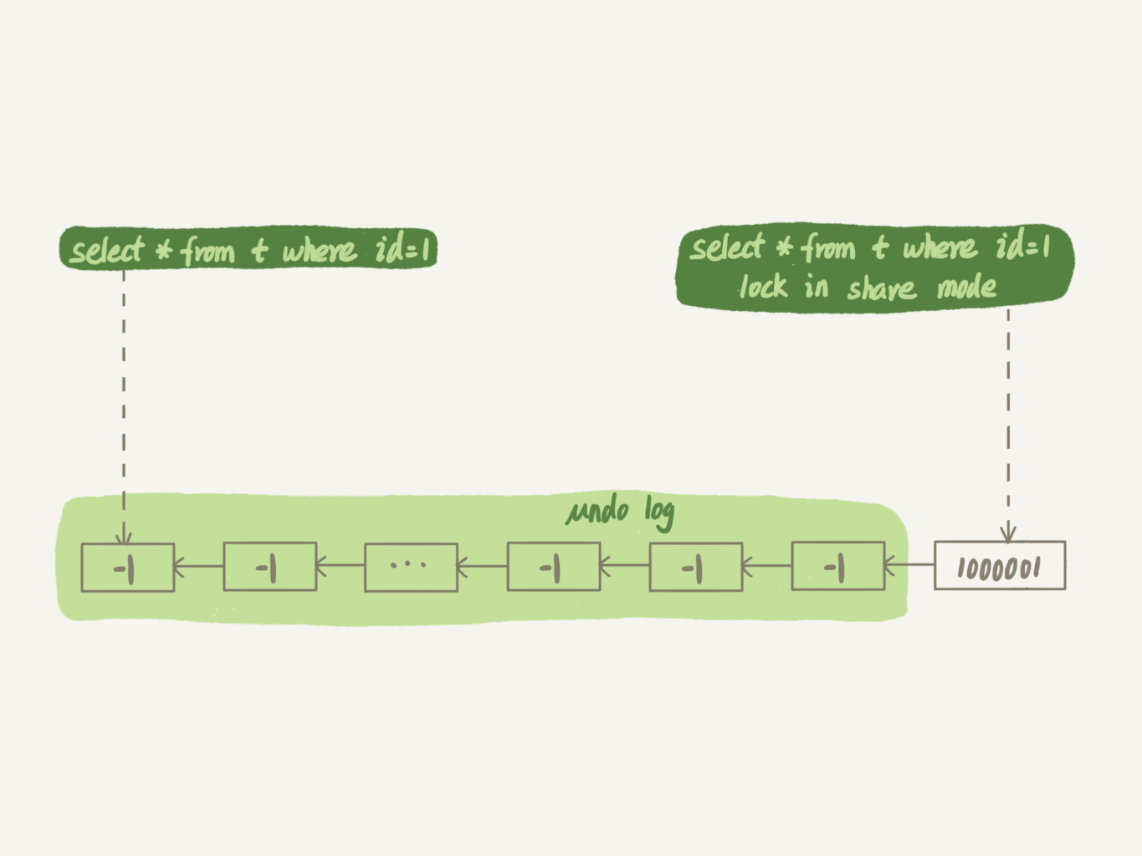
session B 更新完 100 万次,生成了 100 万个回滚日志 (undo log)。
带 lock in share mode 的 SQL 语句,是当前读,因此会直接读到 1000001 这个结果,所以速度很快;而 select * from t where id=1 这个语句,是一致性读,因此需要从 1000001 开始,
依次执行 undo log,执行了 100 万次以后,才将 1 这个结果返回。
注意,undo log 里记录的其实是“把 2 改成 1”,“把 3 改成 2”这样的操作逻辑,画成减 1 的目的是方便你看图。
小结
今天我给你举了在一个简单的表上,执行“查一行”,可能会出现的被锁住和执行慢的例子。这其中涉及到了表锁、行锁和一致性读的概念。
在实际使用中,碰到的场景会更复杂。但大同小异,你可以按照我在文章中介绍的定位方法,来定位并解决问题。
最后,我给你留一个问题吧
我们在举例加锁读的时候,用的是这个语句,select * from t where id=1 lock in share mode。由于 id 上有索引,所以可以直接定位到 id=1 这一行,因此读锁也是只加在了这一行上。
但如果是下面的 SQL 语句,
begin;
select * from t where d=5 for update;
commit;
这个语句序列是怎么加锁的呢?加的锁又是什么时候释放呢?
你可以把你的观点和验证方法写在留言区里,我会在下一篇文章的末尾给出我的参考答案。感谢你的收听,也欢迎你把这篇文章分享给更多的朋友一起阅读。
上期问题时间
在上一篇文章最后,我留给你的问题是,希望你可以分享一下之前碰到过的、与文章中类似的场景。
@封建的风 提到一个有趣的场景,值得一说。我把他的问题重写一下,表结构如下:
mysql> CREATE TABLE `table_a` (
    `id` int(11) NOT NULL,
    `b` varchar(10) DEFAULT NULL,
    PRIMARY KEY (`id`),
    KEY `b` (`b`)
) ENGINE=InnoDB;
假设现在表里面,有 100 万行数据,其中有 10 万行数据的 b 的值是’1234567890’, 假设现在执行语句是这么写的:
mysql> select * from table_a where b='1234567890abcd';这时候,MySQL 会怎么执行呢?
最理想的情况是,MySQL 看到字段 b 定义的是 varchar(10),那肯定返回空呀。可惜,MySQL并没有这么做。
那要不,就是把’1234567890abcd’拿到索引里面去做匹配,肯定也没能够快速判断出索引树 b 上并没有这个值,也很快就能返回空结果。
但实际上,MySQL 也不是这么做的。
这条 SQL 语句的执行很慢,流程是这样的:
- 在传给引擎执行的时候,做了字符截断。因为引擎里面这个行只定义了长度是 10,所以只
截了前 10 个字节,就是’1234567890’进去做匹配; - 这样满足条件的数据有 10 万行;
- 因为是 select *, 所以要做 10 万次回表;
- 但是每次回表以后查出整行,到 server 层一判断,b 的值都不是’1234567890abcd’;
- 返回结果是空。
这个例子,是我们文章内容的一个很好的补充。虽然执行过程中可能经过函数操作,但是最终在拿到结果后,server 层还是要做一轮判断的。
评论区留言点赞板:
@赖阿甘 提到了等号顺序问题,时间上 MySQL 优化器执行过程中,where 条件部分, a=b 和 b=a 的写法是一样的。
@沙漠里的骆驼 提到了一个常见的问题。相同的模板语句,但是匹配行数不同,语句执行时间相差很大。这种情况,在语句里面有 order by 这样的操作时会更明显。
@Justin 回答了我们正文中的问题,如果 id 的类型是整数,传入的参数类型是字符串的时候,可以用上索引。
Q&A
RR隔离级别下,为保证binlog记录顺序,非索引更新会锁住全表记录,且事务结束前不会对不符合条件记录有逐步释放的过程。
回答: 准确
愉快的做一下思考题
begin;
select * from t where c=5 for update;
commit;
历史知识的结论是,innodb先锁全表的所有行,返回server层,判断c是否等于5,然后释放c!=5的行锁。
验证方法:
事务A执行 锁住一行c!=5的记录 比如id =3 c=3
select * from t where id = 3 for update 或者 update t set c=4 where id =3
然后启动新事务B执行上面的语句select * from t where c=5 for update; 看看有没有被阻塞。
用于判断事务B的语句会不会试图锁不满足条件的记录。
然后把事务A和事务B的执行顺序对调一下,也就是先执行B在执行A。看看有没有阻塞,
判断在事务B加锁成功的情况下会不会释放不满足查询条件记录的行锁。
回答: 👍🏿 思路清晰
隔离级别再愉快地改成RR试试😄
问一下:索引扫描与全表扫描,有什么异同点?
作者回复: 一般说全表扫描默认是值“扫瞄主键索引”
lock table t1 write这个写锁跟mdl写锁,本质上是不是一个东西?
作者回复: 在5.5及以后的版本中,lock table t1 write 就是通过加mdl写锁,来阻止其他线程访问的
亲爱的老师, 我这里有一个问题? 困惑好久
一致性读为啥还要处理别的事务回滚日志?一致性读不是直接返回视图里的值吗?undo log在没有事务使用的时候会清除掉?
作者回复: 你再看下08篇哈。
简单说,一致性视图只是一个数组+一个高水位,是要靠undo log来获取老版本的数据的
老师,我有个问题问,在讲隔离级别的时候讲过可重复读级别下,默认读操作(select查询,不是当前读)读到的是某条数据的某个历史版本,而所有这些历史版本数据都是以undo log的形式存在的对吗?需要找某个历史版本数据就直接执行对应undo log,而不是事先把历史版本的数据保存下来,是这样的吗?
作者回复: 是的
所以,出现 Waiting for table flush 状态的可能情况是:有一个 flush tables 命令被别的语句堵住了,然后它又堵住了我们的 select 语句。
记得之前文章讲 flush table会导致该表 不能增改删 但是为什么session c的查询也会被block呢
作者回复: Flush 过程中,查也不行的
老师我请教一个问题:
flush tables中close table的意思是说的把open_tables里的表全部关闭掉?下次如果有关于某张表的操作
又把frm file缓存进Open_table_definitions,把表名缓存到open_tables,还是open_table只是一个计数?
不是特别明白flush table和打开表是个什么流程
作者回复: Flush tables是会关掉表,然后下次请求重新读表信息的。
第一次打开表其实就是open_table_definitions,包括读表信息一类的。
之后再有查询就是拷贝一个对象,加一个计数这样的。
老师,最近遇到了一个问题,看您有什么建议。
业务场景是这样的:
1.开启事务
2.在表a插入一条记录
3.在表b更新一条记录
4.在表c更新一条记录
5.提交事务
看程序日志所有sql都没问题(没看数据库日志),但是结果是2的那条插入了,3和4都没更新,这个问题有哪几种情况?
作者回复: 这是被别的并发事务又改回去了吗😓
要么是update的值跟原值相同,
要么是update条件没有匹配到行。
额,最好给一下每个语句执行后的affacted rows , 还有binlog里的日志内容,才好分析。
课后问题:d这一列不存在,但是还是要加MDL锁,释放时间应该是事务提交时。
作者回复: 抱歉,是要写成where c=5 , 发起堪误了
select * from t where id = 1執行800那个case,如果将sessionA的start transaction with consistant snapshot改为start transaction则不会执行那么慢,原因,这种情况下会在执行第一个select的时候才真正开启事务,因为sessionB没有显示开启事务,但是执行update语句本身就有事务,只不过执行完即提交,那么select * from t where id = 1将会返回最新值,也就是1000001
作者回复: 对的
这个知识点由于在前面的文章中已经提到过,就没再展开
实操了一把。在RR级别下,无论X锁还是S锁。如果对带索引的字段加锁,只会锁住指定数据行。但是对无索引字段进行加锁,会对整表数据进行逐一加锁。
作者回复: 如果对带索引的字段加锁,只会锁住指定数据行,
还有间隙哈, 可以跳看一下21篇
文末, 评论区留言点赞板:
@赖阿甘 提到了等号顺序问题,时间上 MySQL 优化器执行过程中,where 条件部分, a=b 和 b=a 的写法是一样的。
中
“时间上”是否笔误?按语境可能是“实际上”?
作者回复: 是的,👍细致,我们发起勘误
带 lock in share mode 的 SQL 语句,是当前读,因此会直接读到 1000001 这个结果,所以速度很
快;而 select * from t where id=1 这个语句,是一致性读,因此需要从 1000001 开始,依次执行
undo log,执行了 100 万次以后,才将 1 这个结果返回。
问题:
1、意思是直接读速度比执行undo log快?
2、真实情况会存在这种情况吗?即:一条记录被update执行了很多次,一堆undo log,而没有commint。
作者回复: 1.直接读肯定快呀
2.看代码怎么写了😆
老师,创建的这个十万行的表t,我用drop table t进行删除,发现需要很长时间,是什么问题造成的?
作者回复: 正常应该很快才对,
你show processlist 发来看下,一种可能是mdl锁等待
思考题解法:
c无索引x锁应该是锁表。
解锁我觉得应该是sessionb的事物提交之后
作者回复: 不是锁表哈,innodb里面除非明确写lock table,不会锁表;
解锁时机对的
思维导图(AI生成)